Regístrate para despachos de nuestro taller público
Cómo lo construimos: Cleveland Police Discipline
Las piezas detrás de Cleveland Police Discipline: los Documenters ingresan los registros, un modelo escribe los resúmenes con reglas estrictas y un sitio liviano, que funciona sin conexión, toma prestado el aspecto de Signal Cleveland.
4 de noviembre de 2026 · David Eads · Editado por Tory Lysik
Read in English →Nuestro ensayo reciente, ”Los humanos reportan, la IA remezcla”, explica la idea detrás de Cleveland Police Discipline, nuestra herramienta de consulta. Este texto complementario cuenta cómo funciona: el ingreso de datos, el proceso con IA, el frontend y las piezas que hacen que se sienta parte del sitio web de Signal Cleveland, aunque funciona totalmente por fuera del sistema de gestión de contenidos de Signal.
Ingreso de datos: personas, no scrapers
Los Cleveland Documenters leen los avisos disciplinarios que el departamento de policía publica en PDF. Los avisos describen lo que pasó en cada audiencia.
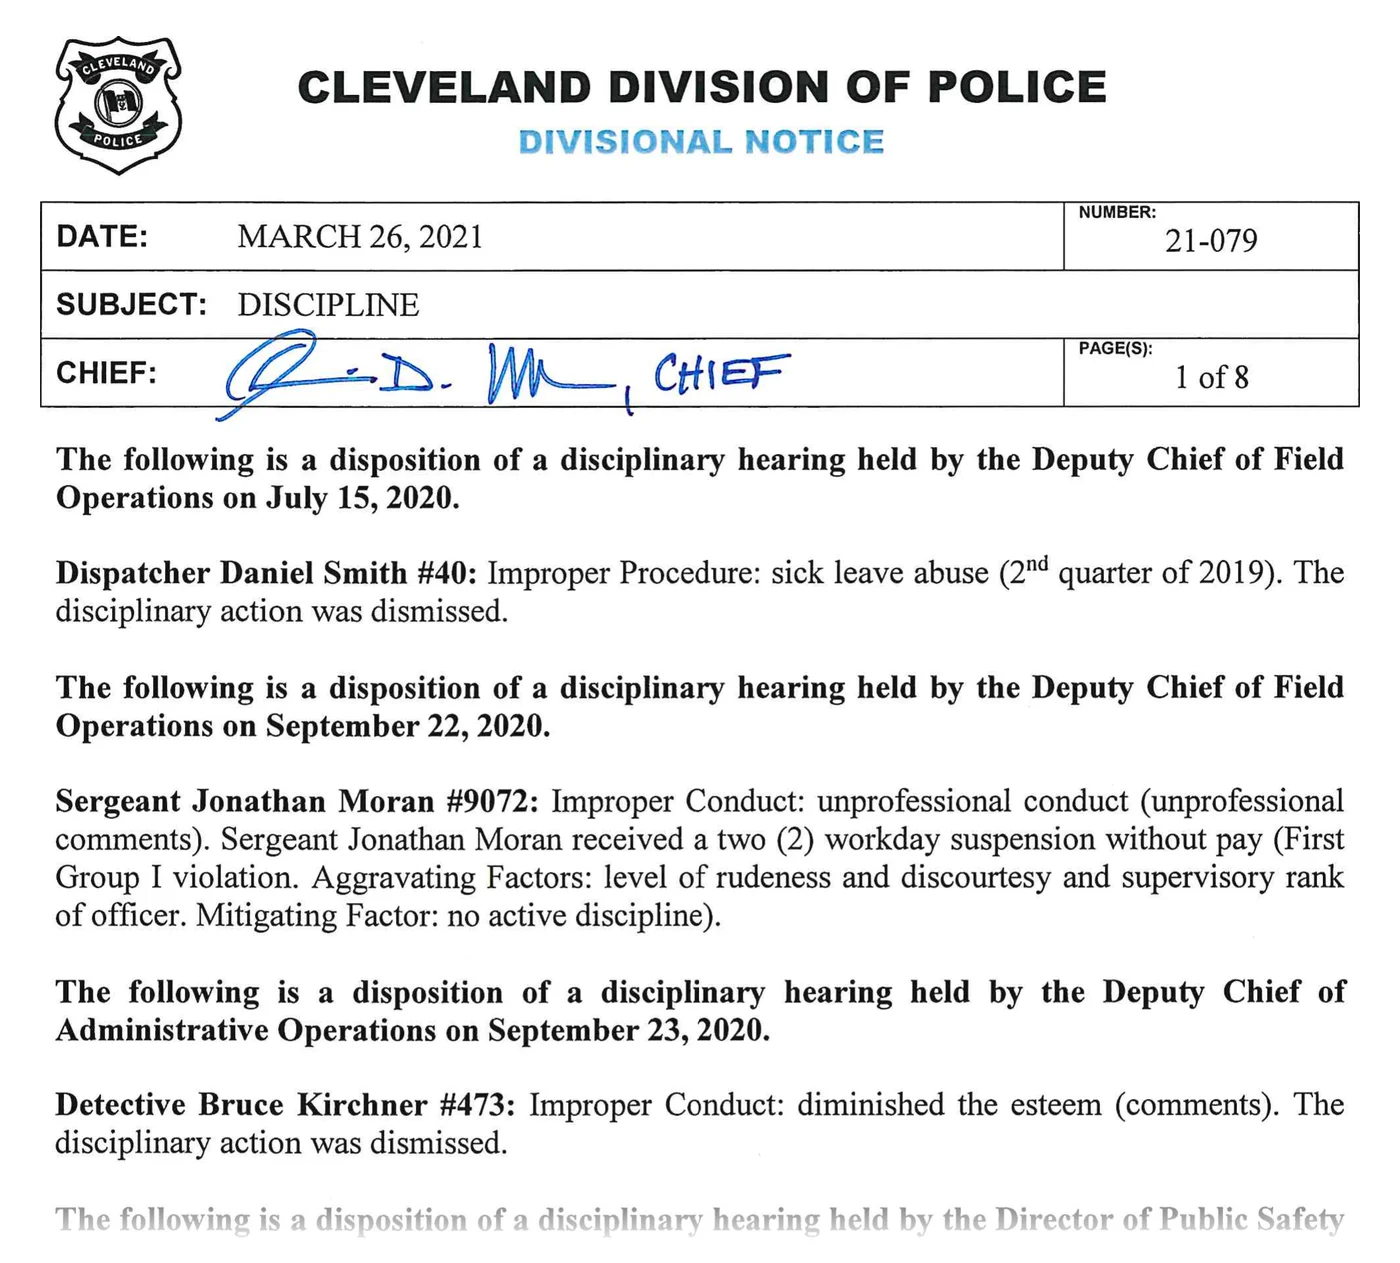
Los Documenters mantienen simple el ingreso de datos. Para cada caso, pasan a Airtable los elementos clave: el agente, la fecha de la audiencia, el texto que describe los cargos y el resultado, y el tipo de acción. Vinculan el caso con el agente y con el documento original, lo clasifican a grandes rasgos y pasan al siguiente.
La IA también podría haber hecho la extracción. Podríamos haber armado a punta de prompts un scraper para el texto no estructurado de los avisos, pero hacerlo confiable habría costado horas caras de ingeniería, un control de calidad engorroso y muchos tokens. El proyecto empezó justo cuando los LLM empezaban a despegar, así que la IA no fue una opción real hasta que ya íbamos muy avanzados. Cuando volvimos a revisar la pregunta a principios de este año, el costo salió más o menos igual que pagarles a los Documenters.
La escala también importa. Con conjuntos de datos muy grandes, a veces automatizar es la única salida, y lo que se gana justifica renunciar a la participación humana. Con unos 1,800 registros, las personas eran la mejor opción. Resuelven sin problema los casos raros, y el proceso que sigue recibe datos limpios y predecibles: menos datos misteriosos que depurar y menos casos especiales que programar.
El proceso con IA
Un script de actualización de datos toma los casos de Airtable y envía cada uno a los modelos GPT de OpenAI para tres tareas:
- Un resumen. El modelo reescribe el aviso como un párrafo corto sobre el resultado, seguido de listas de los cargos y de los factores atenuantes y agravantes, si los hay. El prompt dice que los resúmenes están “pensados para leerse en un sitio web y en pantallas pequeñas sin sacrificar la precisión ni simplificar de más el lenguaje”.
- Un título. Una línea que empieza por la sanción impuesta, como “Amonestación escrita por procedimiento indebido de registro e incautación”, con las siglas escritas completas.
- Una clasificación. Un pequeño objeto JSON con el resultado (culpable, no culpable, desestimado o desconocido), el grupo de gravedad, si el empleado fue despedido y la sanción impuesta. Los campos de resultado y despido alimentan el recuadro “At a glance” en la página de cada agente, y los cuatro van a las exportaciones en CSV.
Las reglas de los prompts hacen buena parte del trabajo de generar confianza:
- Ceñirse al texto. Los resúmenes se limitan a lo que el aviso respalda explícitamente. Cuando un aviso dice que algo es una “primera” o “segunda” falta, el resumen se lo atribuye al aviso (“Según el aviso divisional, esto se trató como una primera infracción del Grupo I”) en lugar de afirmarlo, y el modelo nunca cuenta las faltas por su cuenta.
- La gravedad tiene que estar nombrada. El modelo asigna el Grupo I, II o III solo si el aviso lo dice literalmente. El prompt le dice: “NO deduzcas ni adivines un nivel de grupo a partir del tipo de sanción”. Las acciones no disciplinarias son “desconocidas” por regla. Por eso, casi un tercio de los casos tiene una gravedad desconocida, y es a propósito.
- “Despedido” significa despedido. Las renuncias, las jubilaciones y las ausencias a la audiencia no cuentan como despidos. Solo cuenta un despido explícito.
- El conocimiento del tema va en los prompts. Cuando un agente renunció mientras tenía cargos pendientes, el título empieza por “Renunció”, no por “Desestimado”, aunque los cargos se hayan retirado después. Esa regla vino de personas que habían pasado tiempo con los registros.
- Las fechas salen primero de los campos estructurados. Para los despidos, el proceso usa la fecha de la audiencia, la fecha del informe o la fecha de despido que figura en Airtable. Solo cuando faltan todas intenta sacar una fecha del texto, primero con una simple búsqueda de patrones y después con un modelo al que se le pide “ser conservador; no adivinar fechas inciertas”. Si no está seguro, la fecha queda como desconocida.
- Estilo de la casa. Estilo AP sin coma de Oxford, en pasado, en tercera persona y sin números de avisos divisionales. El glosario se encarga de las referencias a las normas.
Las salvaguardas alrededor del modelo:
- Los resúmenes verificados no cambian. Cada resumen se genera una vez y se conserva, para que una actualización de datos no reescriba en silencio algo que una persona ya revisó.
- Las clasificaciones se vuelven a generar solo cuando cambia el texto. La caché usa como clave un hash del texto del caso, al que antes se le quitan los enlaces al glosario, así que editar el glosario no devuelve los casos al modelo.
- Si el modelo falla, se muestra el original. Cuando no se puede generar un resumen, el sitio muestra el texto original del aviso.
- Las personas revisan el resultado. Cotejamos casi todos los resúmenes con los registros originales antes de darlos por terminados.
Los lectores atentos notarán que no nombramos un modelo. Fuimos cambiando a medida que salían versiones más nuevas y capaces, y cada una necesitaba menos edición y menos ingeniería de prompts. Las anteriores funcionaban bien y revisamos los resultados sobre la marcha, así que distintos modelos escribieron distintos resúmenes, según cuándo pasó cada registro por el proceso.
Un frontend rápido que funciona sin conexión
El sitio está hecho con SvelteKit. En la primera visita, el navegador descarga todo el conjunto de datos (agentes, casos, resúmenes y el glosario) en un par de archivos JSON. A partir de ahí, todo pasa en el navegador, y los datos nunca vienen de una base de datos en vivo:
- FlexSearch construye un índice de texto completo en un web worker, así que la búsqueda nunca congela la página.
- La navegación y la búsqueda son instantáneas.
- Un service worker guarda en caché el sitio y sus datos.
Una vez cargado, el sitio sigue funcionando sin conexión a internet. Eso sirve si se cae la señal durante una protesta u otro evento grande con presencia policial, y vale igual en una de las grandes ciudades menos conectadas del país.
El alojamiento también es sencillo. El sitio corre en AWS (S3, CloudFront y una pequeña función Lambda, desplegados con SST), y las páginas se guardan en caché en el borde de la red. No hay una base de datos que escalar, y si Airtable tiene un mal día, el sitio sigue funcionando. Eso le va bien a una redacción pequeña que no puede cargar con deuda de mantenimiento ni dejarlo todo por una crisis de servidores.
Integración con el sitio principal
El sitio vive en un subdominio de Signal Cleveland y está diseñado para sentirse parte del sitio principal, que funciona con Newspack:
- Los datos viven fuera del CMS de Signal. El script de actualización escribe archivos JSON y CSV simples, así que publicar datos nuevos es actualizar y desplegar.
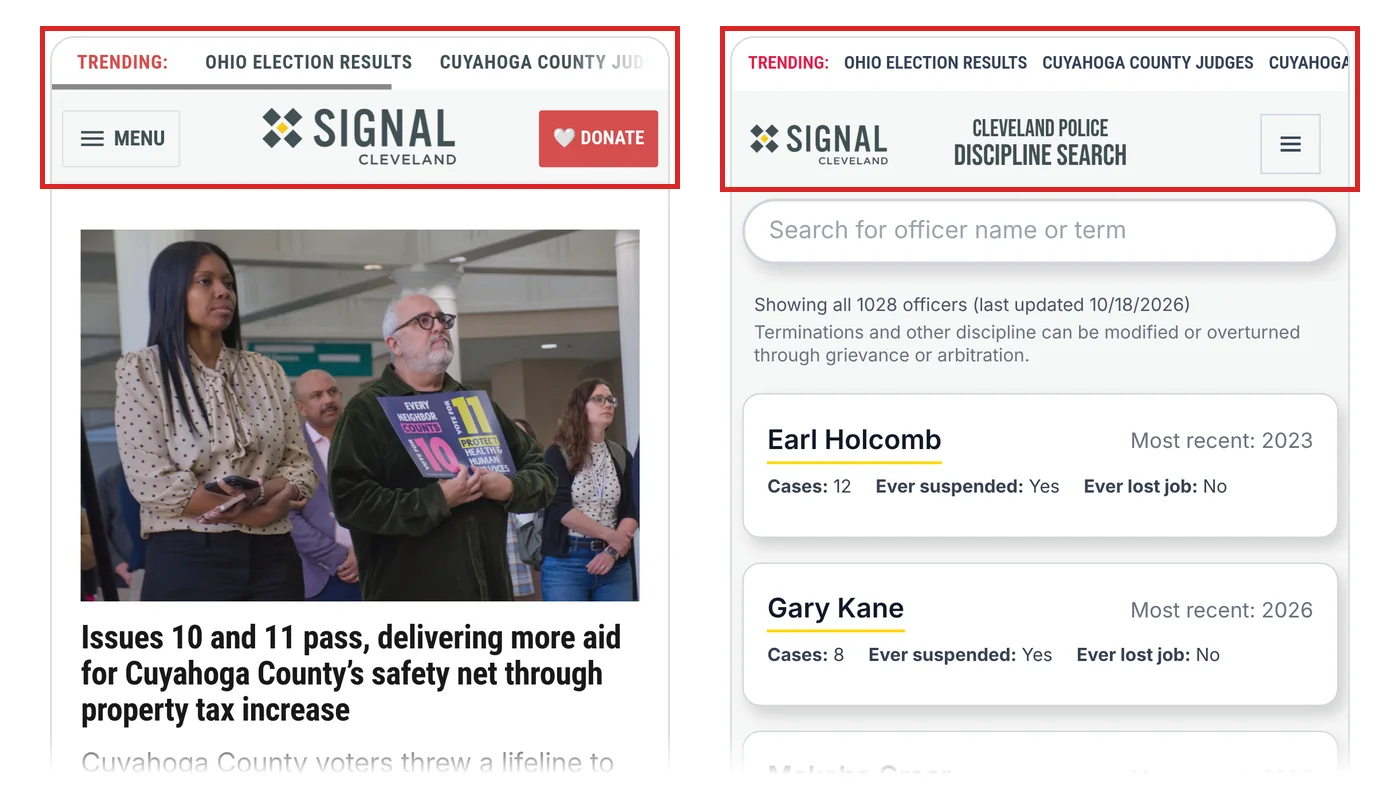
- Un pequeño endpoint de API lee la portada de Signal y extrae las piezas de su encabezado: el logo, los enlaces de “Trending” y de redes sociales, los botones de boletines y donaciones, y los menús de secciones, que en los teléfonos quedan detrás de un botón de menú. Las respuestas se guardan en caché en el borde hasta por una hora. Si no se puede llegar al sitio de Signal, el encabezado usa la última copia que guardó el navegador o una versión mínima incorporada.
- Despliegues separados de pruebas y producción permiten que los editores revisen datos y funciones nuevas antes de publicarlos.
- La analítica se comparte con el sitio principal, así que el tráfico del sitio de disciplina aparece automáticamente en los informes habituales de Signal.
El endpoint de la portada hace casi todo el trabajo de que el sitio se sienta como el de Signal. En la práctica es un scraper diminuto y con caché agresiva: toma elementos clave del sitio principal, los convierte en estructuras de datos ordenadas y se los pasa a plantillas que imitan el aspecto del sitio principal sin ser idénticas.
La contrapartida es que un rediseño grande del sitio principal podría romperlo. Es una preocupación menor: el diseño de Signal es bastante estable, y un rediseño radical obligaría a actualizar este sitio de todos modos.
Como los datos son archivos simples, el sitio principal podría usar el mismo JSON para fragmentos de SEO o widgets de contenido relacionado sin tocar Airtable. Si más adelante dejamos Airtable, el contrato sigue igual: se genera el JSON una vez y se lleva a cualquier parte.
Un sistema de glosario
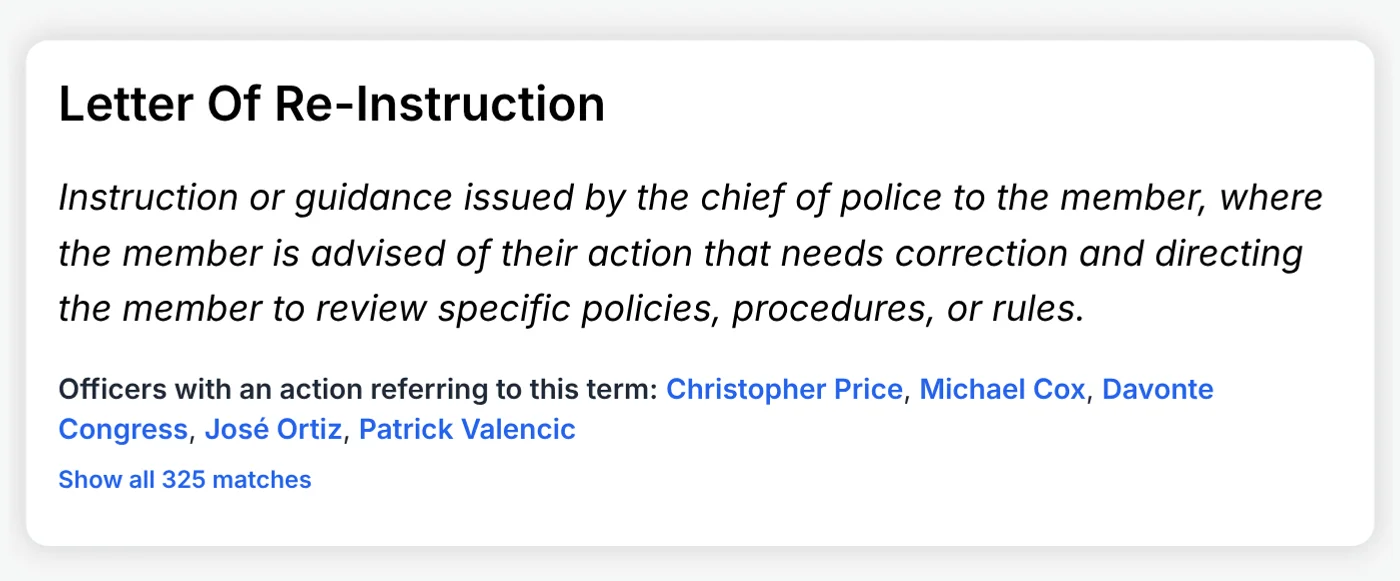
Los avisos disciplinarios están llenos de jerga: “Group I violation”, “letter of re-instruction”, “wearable camera system (WCS)” y “mitigating factors”. El glosario, que los editores mantienen en Airtable, tiene unas 80 entradas publicadas. Cada entrada tiene un buscador de términos, una expresión regular que le dice al proceso cómo encontrar el término en el texto de los casos:
- Los buscadores se combinan en un solo patrón que no distingue mayúsculas de minúsculas.
- Los patrones más largos se prueban primero, así que un término específico gana sobre uno más corto que se le superpone.
- Los términos encontrados se convierten en enlaces a sus definiciones en el glosario, y cada coincidencia queda registrada por agente y por caso.
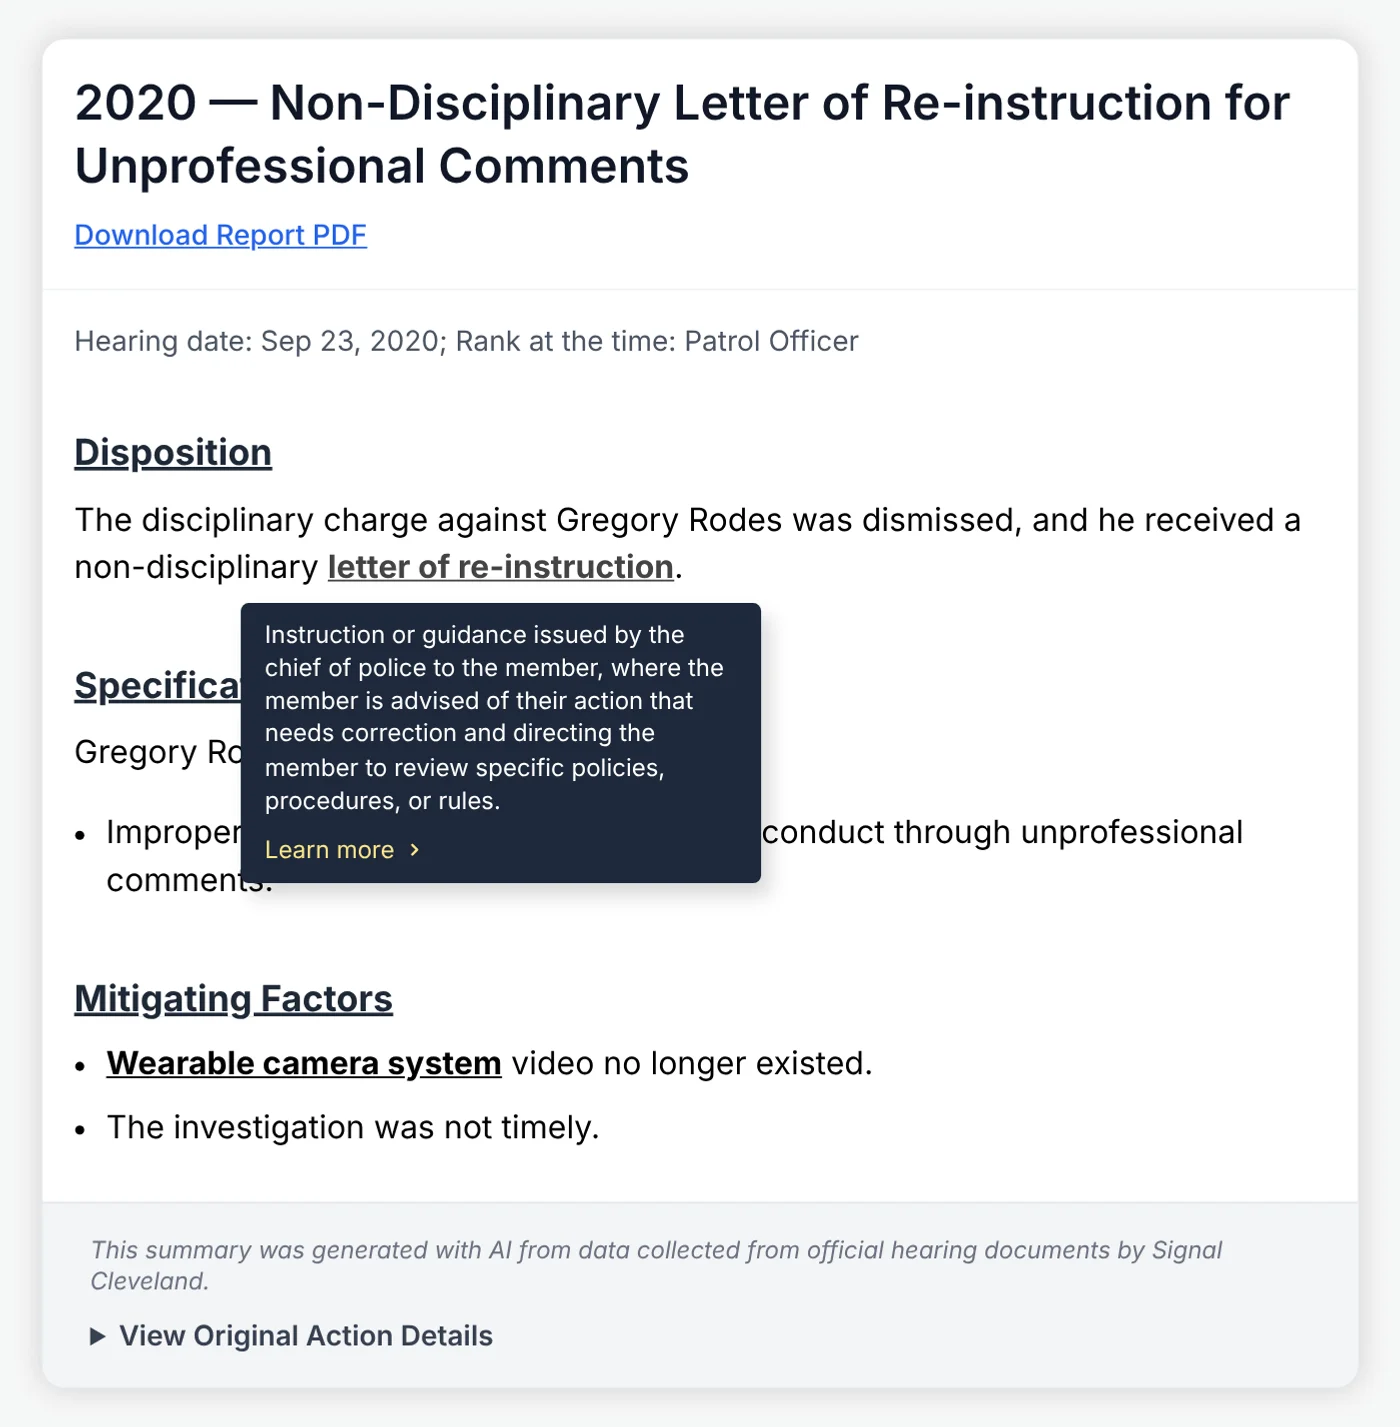
Esto hace que la lectura sea más accesible y les da a los reporteros una forma rápida de ver dónde aparecen los términos clave en todo el conjunto de datos. Como las coincidencias se registran por caso, se pueden hacer preguntas como “¿con qué frecuencia aparecen problemas con las cámaras corporales?” sin releer cada PDF. (El sistema de cámaras corporales aparece en los registros de más de 300 empleados).
También permite que los lectores investiguen por su cuenta. Mucha gente llega a la herramienta para buscar a un agente, pero cada entrada del glosario enlaza a todos los agentes cuyos casos mencionan ese término, así que los lectores pueden seguir un tema que les importa a lo largo de todo el conjunto de datos.
Datos estructurados para seguir investigando
Cada actualización de datos también genera archivos pensados para el análisis, y son públicos:
- officerData.json: agentes, casos, resúmenes y enlaces al glosario. Es el mismo archivo que usa el sitio.
- officer-actions.csv: una fila por caso, con el tipo de audiencia, el resultado, el grupo de gravedad y si terminó en despido.
- officer-actions-categorized.csv: una fila por término del glosario por caso, para contar con qué frecuencia aparecen ciertas normas o temas.
Los reporteros pueden filtrar, cruzar y combinar estos archivos en Excel o con un script, sin una cuenta de Airtable. Los CSV facilitan ver patrones: quién perdió su trabajo, qué casos llegaron al Grupo III, etc. Y como el JSON es el mismo archivo que usa el sitio, cualquier problema en los datos también queda a la vista de los lectores. No hay distancia entre los “datos de análisis” y los “datos del sitio”.
Más que un buscador
Otras funciones surgieron del trabajo con los editores de Signal y los Documenters:
- Los resultados de apelaciones y arbitrajes aparecen en el historial de casos del agente, así que se puede ver cuándo un despido se redujo o se anuló después.
- Las páginas de los agentes enlazan a documentos originales, como cartas de cargos, aunque no logramos vincular de forma confiable cada documento con un caso específico.
- Las búsquedas quedan guardadas en la URL, así que se puede compartir un enlace a un conjunto de resultados.
Ninguna de estas piezas es exótica: una hoja de cálculo, unos cuantos prompts bien escritos, un sitio liviano y mucha lectura humana. Juntas convierten registros que eran públicos en el papel en algo que la gente de verdad puede usar.
¿Tiene registros públicos difíciles de usar? Construimos procesos de datos, herramientas de consulta y exploradores como este. Cuéntenos qué necesita.
Regístrate para despachos de nuestro taller público